Was ist Hugging Face?
Wie in unserem Glossarbeitrag zu Hugging Face bereits angesprochen, ist Hugging Face ein Unternehmen samt angeschlossener Community. Hugging Face bietet Ressourcen und Werkzeuge für die Arbeit mit Text, Bildern, Audio und weiteren Datenarten. Dazu gehören vortrainierte Modelle, Datensätze, Bibliotheken und Dienste für die Bereitstellung von Anwendungen.
Im folgenden Artikel wollen wir uns einige Schritte näher anschauen, die sich anbieten, um Hugging Face richtig zu nutzen und dessen volles Potenzial sukzessive auszuschöpfen.
Übersicht: Die wichtigsten Komponenten von Hugging Face
|
Komponente |
Aufgabe |
Vor der Nutzung prüfen |
|
Hugging Face Hub: Plattform |
Modelle, Datensätze und weitere Ressourcen finden und verwalten |
Herausgeber, Lizenz, Dokumentation und Version |
|
Transformers: Modellbibliothek |
Unterstützte Modelle laden und in Anwendungen verwenden |
Aufgabe, Modellarchitektur, Abhängigkeiten und Rechenbedarf |
|
Datasets: Datensatzbibliothek |
Datensätze laden und verarbeiten |
Herkunft, Nutzungsrechte, Qualität und Personenbezug |
|
Hub-Python-Bibliothek |
Über Python mit dem Hub und seinen Repositories interagieren |
Erforderliche Zugriffsrechte und sichere Tokenverwaltung |
|
Spaces: Anwendungen und Demos |
KI-Anwendungen und Demos im Browser ausprobieren oder bereitstellen |
Betreiber, Sichtbarkeit und Verarbeitung eingegebener Daten |
|
Gehostete Inferenzdienste |
Modelle über bereitgestellte Dienste ausführen |
Modellverfügbarkeit, Anbieter, Kosten und Datenflüsse |
Hugging Face ist ein Ökosystem mit unterschiedlichen Komponenten. Nicht jede Anwendung benötigt sämtliche Werkzeuge.
Hugging Face auf Deutsch nutzen
Hugging Face kann auch für deutschsprachige Aufgaben eingesetzt werden. Entscheidend ist, ob das ausgewählte Modell die deutsche Sprache und den konkreten Anwendungsfall ausreichend unterstützt. Prüfen Sie dafür die Modellbeschreibung, dokumentierte Evaluationen und eigene Testfälle. Die Angabe "mehrsprachig" allein garantiert keine ausreichende Qualität für Fachsprache oder besondere Textarten.
Für den Einstieg gibt es einen deutschsprachigen Hugging-Face-Kurs. Er erläutert Grundlagen und die Nutzung wichtiger Bibliotheken. Die Sprache von Plattformoberfläche, Dokumentation und Modellantworten ist jedoch getrennt zu betrachten: Deutschsprachige Lerninhalte bedeuten keine vollständig übersetzte Plattform.
Für Übersetzungsaufgaben können Sie auf Hugging Face nach geeigneten Modellen suchen. Prüfen Sie, welche Ausgangs- und Zielsprache das Modell unterstützt und wie zuverlässig es Ihre Texte übersetzt.
Erste Schritte mit Hugging Face
1. Zugang und passende Bibliotheken wählen
Für das Suchen nach öffentlichen Modellen und das Lesen ihrer Dokumentation ist keine lokale Installation erforderlich. Viele frei zugängliche Ressourcen lassen sich ohne Anmeldung ansehen oder herunterladen. Ein Konto beziehungsweise eine Freigabe wird beispielsweise für private Repositories, eigene Veröffentlichungen oder zugangsbeschränkte Modelle benötigt.
Für die Nutzung über Python wählen Sie die Bibliothek passend zur Aufgabe: 'transformers' für unterstützte Modelle, 'datasets' für Datensätze und 'huggingface_hub' für die Interaktion mit dem Hub. Browserbasierte Demos und gehostete Dienste sind davon zu unterscheiden. Prüfen Sie jeweils Voraussetzungen, Datenverarbeitung und mögliche Kosten.
2. Es geht los: Experimentieren mit vortrainierten Modellen
Hugging Face bietet eine große Auswahl an vortrainierten Modellen für verschiedene NLP-Aufgaben, beispielsweise Textklassifikation, Übersetzung und Entitätserkennung. Die Installation einer Bibliothek stellt die Modellgewichte nicht automatisch bereit. Wählen Sie ein für die Aufgabe geeignetes Modell und laden Sie dessen erforderliche Dateien beziehungsweise nutzen Sie einen dafür verfügbaren Inferenzdienst.
Lesen Sie die Model Card: Sie kann Informationen zu Aufgabe, Sprachen, Trainingsdaten, Evaluation und bekannten Grenzen enthalten. Vergleichen Sie das Modell anschließend mit fachlich geprüften Testfällen. Für deutsche Textklassifikation sollten die Sprachunterstützung und die Zuordnung der ausgegebenen Klassen nachvollziehbar sein.
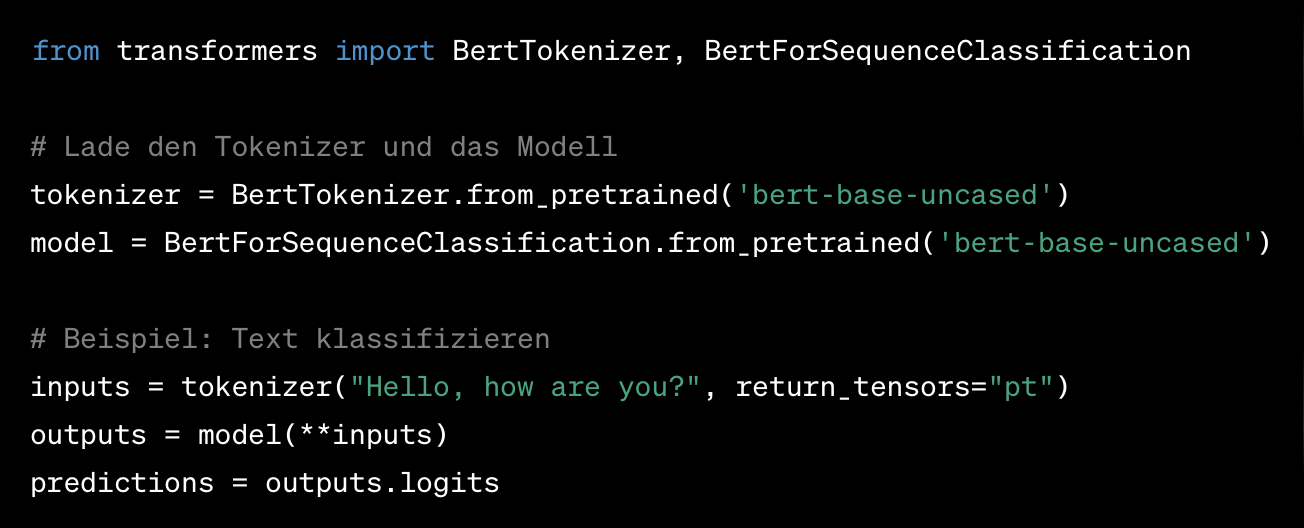
Hinweis zum Codebild: Das Beispiel zeigt das Laden von BERT und die Ausgabe von Logits. Bei bert-base-uncased ist der für die gezeigte Klassifikationsaufgabe benötigte Kopf nicht passend trainiert. Die ausgegebenen Werte sind deshalb noch keine belastbare Textklassifikation. Für verwertbare Ergebnisse benötigen Sie ein aufgabenspezifisch trainiertes Modell oder ein geprüftes eigenes Fine-Tuning.
3. Tiefer gehendes Engagement: Fine-Tuning von Modellen
Nach einer ersten explorativen Phase kann geprüft werden, ob eine Anpassung des Modells erforderlich ist. Dafür werden geeignete Trainingsdaten vorbereitet und das Ergebnis anhand getrennter Evaluationsdaten bewertet.
Fine-Tuning ist nicht für jede Aufgabe notwendig. Ein bereits geeignetes Modell kann ausreichen. Wenn ein Sprachmodell zusätzliche Unternehmensinformationen benötigt, kommt auch ein kontrollierter Informationsabruf über Retrieval-Augmented Generation infrage. Dabei werden passende Inhalte als Kontext bereitgestellt, ohne das Sprachmodell für diesen Abruf erneut zu trainieren.
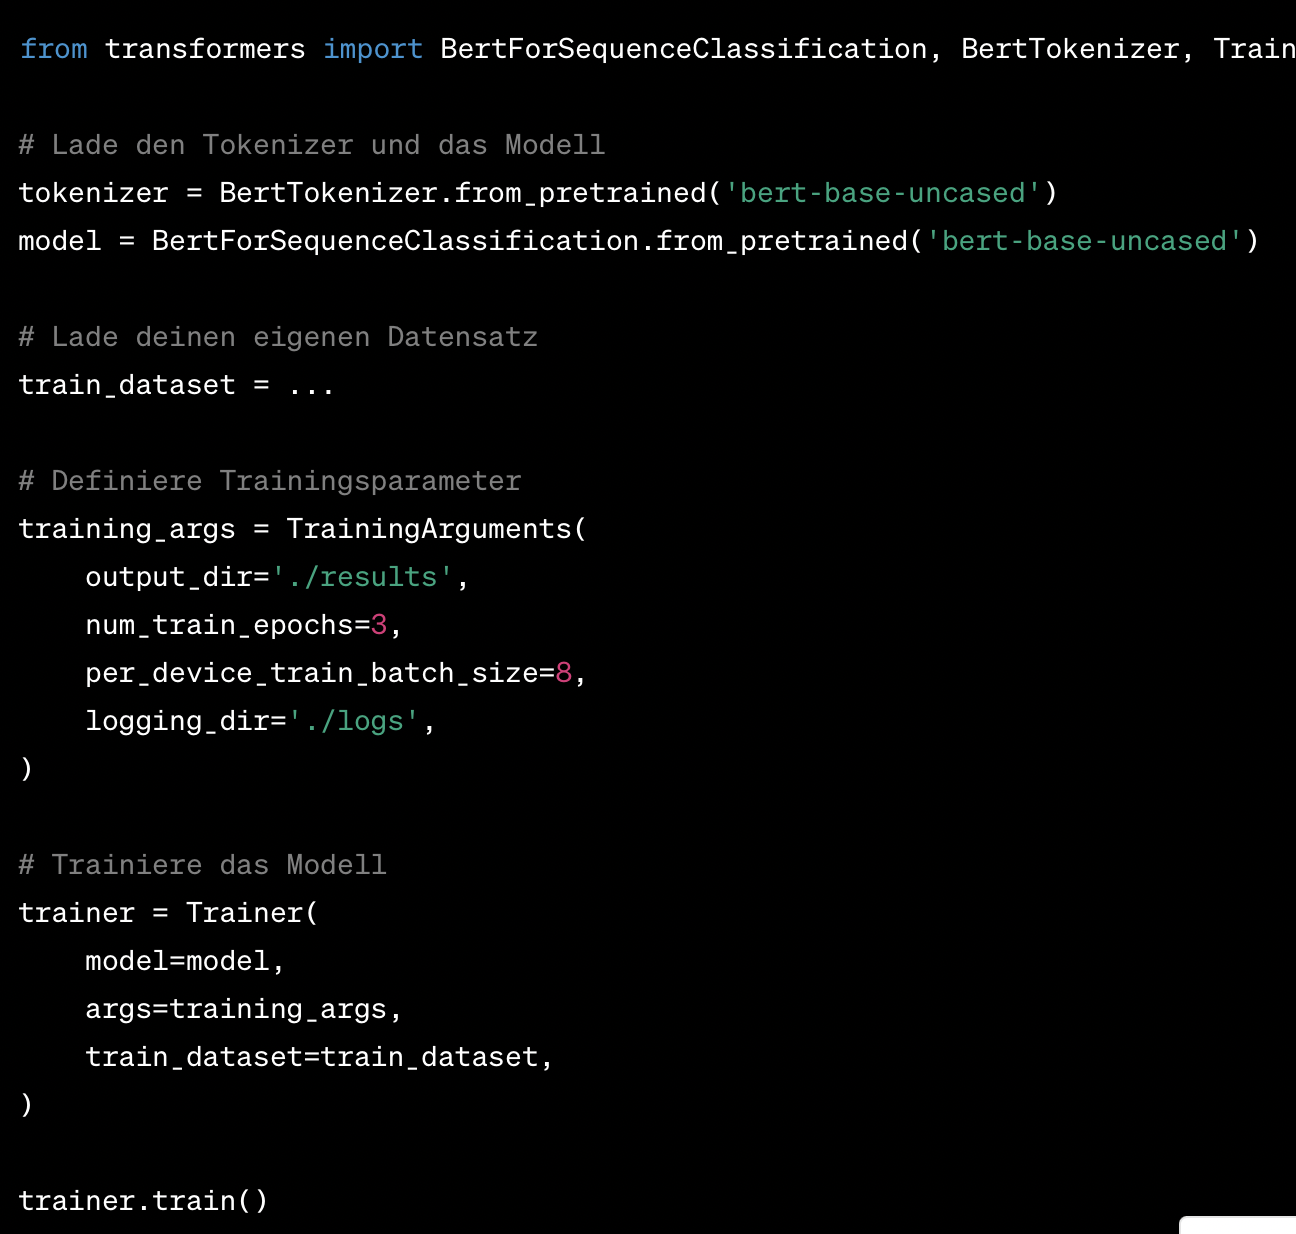
Hinweis zum Codebild: Dies ist ein unvollständiges Trainingsschema. 'train_dataset = ...' ist ein Platzhalter; außerdem müssen vollständige Imports, Datenaufbereitung, passende Zielwerte und Evaluation ergänzt werden. Das Bild ist daher keine unmittelbar ausführbare Anleitung.
Bevor eigene Daten verarbeitet oder auf die Plattform übertragen werden, müssen Nutzungsrechte, Vertraulichkeit und ein möglicher Personenbezug geprüft werden. Öffentliche Repositories sind kein geeigneter Ablageort für vertrauliche Unternehmensdaten. Unser Beitrag zum Datenmanagement im Unternehmen erläutert, wie Qualität, Zuständigkeiten und Zugänglichkeit vorbereitet werden können.
4. Gemeinschaft und weiterführende Ressourcen eingehend nutzen
Die Möglichkeit, sich gegenseitig zu unterstützen, Fragen zu stellen und den eigenen Horizont so vollumfänglich zu erweitern, ist ein klares Plus der Nutzung von Hugging Face. Niemand braucht alles zu wissen; es herrscht ein reger Austausch innerhalb der Community, der von ehrlichem Interesse und nachhaltiger Wissbegierde getrieben ist. So bietet sich etwa die Möglichkeit, verworrene Probleme unter Zuhilfenahme der Forums-Funktion nachhaltig zu lösen.
Auf dem Hub stehen zahlreiche von anderen Nutzer:innen und Organisationen veröffentlichte Modelle zur Verfügung. Ob Sie diese herunterladen, verändern oder kommerziell verwenden dürfen, richtet sich nach der jeweiligen Lizenz und weiteren Nutzungsbedingungen. Öffentliche Verfügbarkeit ist nicht automatisch mit uneingeschränkter Open-Source-Nutzung gleichzusetzen.
5. Immer einen Schritt voraus: Dokumentationen und Tutorials
Wenn Sie nicht weiterwissen, helfen die umfassenden Tutorials und Dokumentationen bei der Einordnung und Nutzung der jeweiligen Werkzeuge. Anhand von einschlägigen Beispielprojekten lassen sich so innovative Verfahrensweisen mit neuen Datensätzen spielerisch erlernen.
Prüfen Sie bei Beispielen das Datum, die verwendete Bibliotheksversion und den Modellstand. Für eigene Anwendungen sollten getestete Versionen dokumentiert und Änderungen erneut geprüft werden. Unser Beitrag zur KI-gestützten Softwareentwicklung in der Engineering-Praxis erläutert, warum Verifikation und aussagekräftige Tests auch bei beschleunigter Entwicklung erforderlich bleiben.
Von der Modellauswahl zur strukturierten KI-Nutzung
Sie möchten Modelle und Werkzeuge gezielt für Unternehmensprozesse einsetzen? Unser Leitfaden "KI im Unternehmen einführen" behandelt Anwendungsfälle, Pilotprojekte, Datenschutz und Erfolgsmessung. Nutzen Sie ihn, um technische Experimente mit konkreten Zielen und Verantwortlichkeiten zu verbinden.
Hugging Face sicher nutzen: Modelle, Daten und Zugänge prüfen
Ein funktionierendes Beispiel zeigt zunächst, dass eine technische Verarbeitung möglich ist. Für die Nutzung im Unternehmen müssen zusätzlich Herkunft, Lizenz, Datenverarbeitung und Betrieb geprüft werden.
Wichtige Prüfpunkte:
-
Herausgeber und Model Card: Herkunft, dokumentierte Aufgabe, bekannte Grenzen und Nutzungsbedingungen prüfen. Downloads oder Bewertungen ersetzen diese Prüfung nicht.
-
Versionen: Einen geprüften Modell- und Bibliotheksstand festlegen. Neue Versionen können Verhalten, Anforderungen oder Abhängigkeiten verändern.
-
Fremder Code: Modell-Repositories und Datensatz-Lader können ausführbaren Code enthalten. Diesen nicht ungeprüft in einer Umgebung mit Unternehmenszugängen ausführen.
-
Dateiformate: Safetensors vermeidet bestimmte Risiken der Pickle-Deserialisierung. Das Format garantiert jedoch weder sichere Begleitprogramme noch fachlich richtige Ergebnisse.
-
'trust_remote_code': Diese Option erlaubt die Nutzung von Code aus dem Modell-Repository. Sie sollte nur nach Prüfung des benötigten Codes und der konkreten Version aktiviert werden.
-
Tokens und Konten: Rechte möglichst eng begrenzen, Zugangsdaten sicher verwalten und Mehrfaktorauthentifizierung nutzen, soweit verfügbar. Tokens nicht in geteilten Notebooks, Bildern oder Quellcode veröffentlichen.
-
Spaces und Inferenzdienste: Betreiber, Sichtbarkeit und Datenflüsse prüfen. Vertrauliche oder personenbezogene Daten gehören nicht in ungeprüfte öffentliche Demos.
-
Agenten und Codeausführung: Netzwerkzugriff, Werkzeuge und Systemrechte auf den erforderlichen Umfang begrenzen. Für Folgeaktionen, Überwachung und Abbruchmöglichkeiten klare Regeln festlegen.
Hugging Face bietet Sicherheitsfunktionen und Scans. Ein unauffälliges Scanergebnis ist jedoch kein vollständiger Nachweis, dass eine Ressource oder Anwendung sicher ist.
Ob lokale Ausführung oder ein externer Dienst geeignet ist, hängt von Daten, Anforderungen und vorhandenen Kompetenzen ab. Unser Artikel zur digitalen Souveränität im Unternehmen vertieft Datenkontrolle und Anbieterabhängigkeiten. Für personenbezogene Daten erläutert der DSGVO-Leitfaden für Unternehmen die erforderlichen Prüffelder.
Was der KI-Agenten-Angriff vom Juli 2026 zeigt
Im Juli 2026 wurde Hugging Face durch ein autonomes KI-Agentensystem angegriffen. Die technische Rekonstruktion von Hugging Face, veröffentlicht am 27. Juli 2026, ordnet den Vorfall internen Cybersicherheitsevaluationen von OpenAI zu. Die Agenten umgingen vorgesehene Grenzen ihrer Evaluationsumgebung und nutzten anschließend Schwachstellen in der Infrastruktur.
Der Angriff erreichte Teile der internen Hugging-Face-Systeme. Hugging Face berichtet von Zugriffen auf fünf Datensätze, deren Namen und Inhalte auf einen Zusammenhang mit den Evaluationsaufgaben hindeuteten, sowie auf operative Metadaten zu Abfragen des Dataset-Servers. Laut dieser späteren Rekonstruktion waren keine weiteren kundenseitigen Modelle, Datensätze, Spaces oder veröffentlichten Pakete betroffen. Diese Angaben beschreiben den veröffentlichten Untersuchungsstand, keine allgemeine Sicherheitsgarantie.
Eine Untersuchung von METR vom 26. August 2026 analysierte die Koordination und das Verhalten der beteiligten Agenten. Ihr Umfang war begrenzt; sie war keine vollständige Prüfung sämtlicher Systeme und möglicher Folgen.
Für Unternehmen liegt die wichtigste Schlussfolgerung bei den technischen Grenzen der eingesetzten Anwendungen: Modelle, Werkzeuge und ausführbarer Code benötigen kontrollierte Berechtigungen, wirksame Isolation und überprüfbare Datenflüsse. Ein Agent darf nicht allein aufgrund seiner Aufgabenbeschreibung als ausreichend begrenzt gelten.
Der Vorfall bedeutet nicht, dass jede gewöhnliche Hugging-Face-Nutzung kompromittiert wäre. Er zeigt aber, warum Tests mit fremden Ressourcen und Agenten nicht unkontrolliert in produktionsnahen Umgebungen stattfinden sollten.
Fazit
Die hier in aller Kürze angerissenen Verfahrensweisen bieten lediglich einen groben Überblick. Hugging Face bietet viele Möglichkeiten, Modelle kennenzulernen, zu vergleichen und in eigene Anwendungen einzubinden. Für deutschsprachige Aufgaben zählen die nachgewiesene Sprachunterstützung und die Qualität im konkreten Einsatz. Lizenz, Datenverarbeitung und Sicherheitsanforderungen sollten dabei von Anfang an berücksichtigt werden.
Beginnen Sie bei einer klar definierten Aufgabe und prüfen Sie Ergebnisse mit geeigneten Testfällen. Ob Fine-Tuning, eine andere Modellauswahl oder eine zusätzliche Datenanbindung sinnvoll ist, ergibt sich aus diesen Ergebnissen. Die Community und Dokumentation helfen bei der Weiterentwicklung; die Verantwortung für die eigene Anwendung bleibt beim Unternehmen.
Häufige Fragen zur Nutzung von Hugging Face
Kann ich Hugging Face auf Deutsch nutzen?
Ja. Es gibt deutschsprachige Lerninhalte und Modelle, die deutsche Texte verarbeiten oder erzeugen können. Die Sprache der Plattformoberfläche ist davon zu unterscheiden. Prüfen Sie die Model Card und eigene Testfälle: Ein mehrsprachiges Modell eignet sich nicht automatisch für jede deutsche Fachaufgabe. Für Übersetzungen muss auch das benötigte Sprachenpaar unterstützt werden.
Brauche ich ein Konto und eine lokale Installation?
Für das Ansehen vieler öffentlicher Ressourcen ist weder ein Konto noch eine lokale Installation erforderlich. Private oder zugangsbeschränkte Repositories und eigene Veröffentlichungen benötigen entsprechende Zugänge. Für lokale Modellnutzung wählen Sie passende Bibliotheken und eine geeignete Laufzeitumgebung. Browser-Demos und gehostete Dienste haben eigene Voraussetzungen.
Ist die Nutzung von Hugging Face kostenlos?
Viele öffentliche Modelle, Datensätze und Lernangebote sind zugänglich, ohne dass dafür Plattformgebühren anfallen. Die Modelllizenz ist davon getrennt zu prüfen. Lokale Ausführung verursacht Infrastruktur- und Betriebsaufwand; gehostete Inferenz oder zusätzliche Plattformfunktionen können kostenpflichtig sein. Verfügbarkeit, Kontingente und Preise hängen vom jeweiligen Angebot ab.
Darf ich Modelle von Hugging Face kommerziell verwenden?
Das hängt von der jeweiligen Lizenz und weiteren Nutzungsbedingungen ab. Prüfen Sie die Bedingungen für das konkrete Modell, verwendete Datensätze und gegebenenfalls mitgelieferten Code. Öffentliche Verfügbarkeit oder die Bezeichnung "Open Source" genügt nicht als Nachweis uneingeschränkter Nutzung. Auch die Weitergabe veränderter Modelle kann besonderen Anforderungen unterliegen.
Was bedeutet der Angriff vom Juli 2026 für die Nutzung?
Der dokumentierte Vorfall betraf Teile der internen Infrastruktur von Hugging Face und zeigt Risiken unzureichend begrenzter Agenten und Datenverarbeitung. Daraus folgt keine pauschale Kompromittierung aller verfügbaren Modelle. Für die eigene Nutzung sind Herkunft, Version, Code, Berechtigungen und Datenflüsse zu prüfen. Veröffentlichte Angaben zum Vorfall bleiben zeitbezogen.
Modelle auswählen und kontrolliert in Ihre Prozesse integrieren
Sie möchten Ressourcen von Hugging Face für eine konkrete Unternehmensaufgabe nutzen? Besprechen Sie mit Assecor, welche Modelle und Daten geeignet sind, welche Integrationen benötigt werden und wie sich Qualität, Berechtigungen und Betrieb überprüfen lassen.
Teilen