
KI im Engineering: Zwischen Produktivitätsversprechen und Praxisrealität
Mehr als 70 Prozent der Entwickler:innen weltweit nutzen heute KI-Tools in ihrem Arbeitsalltag, das zeigt der Stack Overflow Developer Survey 2024. Gleichzeitig beobachtete eine frühe METR-Studie in realen Projekten eine Verlangsamung von bis zu 19 Prozent, obwohl die Beteiligten vorher eine Beschleunigung von 24 Prozent erwartet hatten.
Wie passt das zusammen? Die Antwort liegt nicht in den Tools selbst. Sondern darin, was passiert, wenn KI das Coding beschleunigt und welche Teile des Engineering-Prozesses dann zum neuen Engpass werden.
Unser Kollege Miguel Angel Mesa Cordoba, Entwickler bei Assecor, hat auf dem WeAreDevelopers World Congress 2026 in Berlin drei Tage lang genau diese Frage verfolgt und dazu selbst einen Vortrag mit dem Titel "Von KI-Hype zu Engineering-Praxis" gehalten. Ich habe seine zentralen Erkenntnisse für diesen Artikel zusammengetragen und ordne sie im Folgenden für Entwickler:innen und IT-Leitungen ein, die KI nicht nur einsetzen, sondern in ihrer tatsächlichen Wirkung auf Prozesse, Teams und Systemqualität verstehen wollen.
Was KI in der Softwareentwicklung wirklich verändert
KI-gestützte Softwareentwicklung bezeichnet den systematischen Einsatz von KI-Modellen und Werkzeugen entlang des gesamten Software Development Lifecycle, von der Anforderungserfassung über Codegenerierung und Testing bis zu Deployment und Wartung. Was sich dabei verändert, ist weniger offensichtlich als es auf den ersten Blick erscheint: KI nimmt Engineering-Arbeit nicht einfach weg. Sie verschiebt den Bottleneck.
Drei Verschiebungen, ein Muster
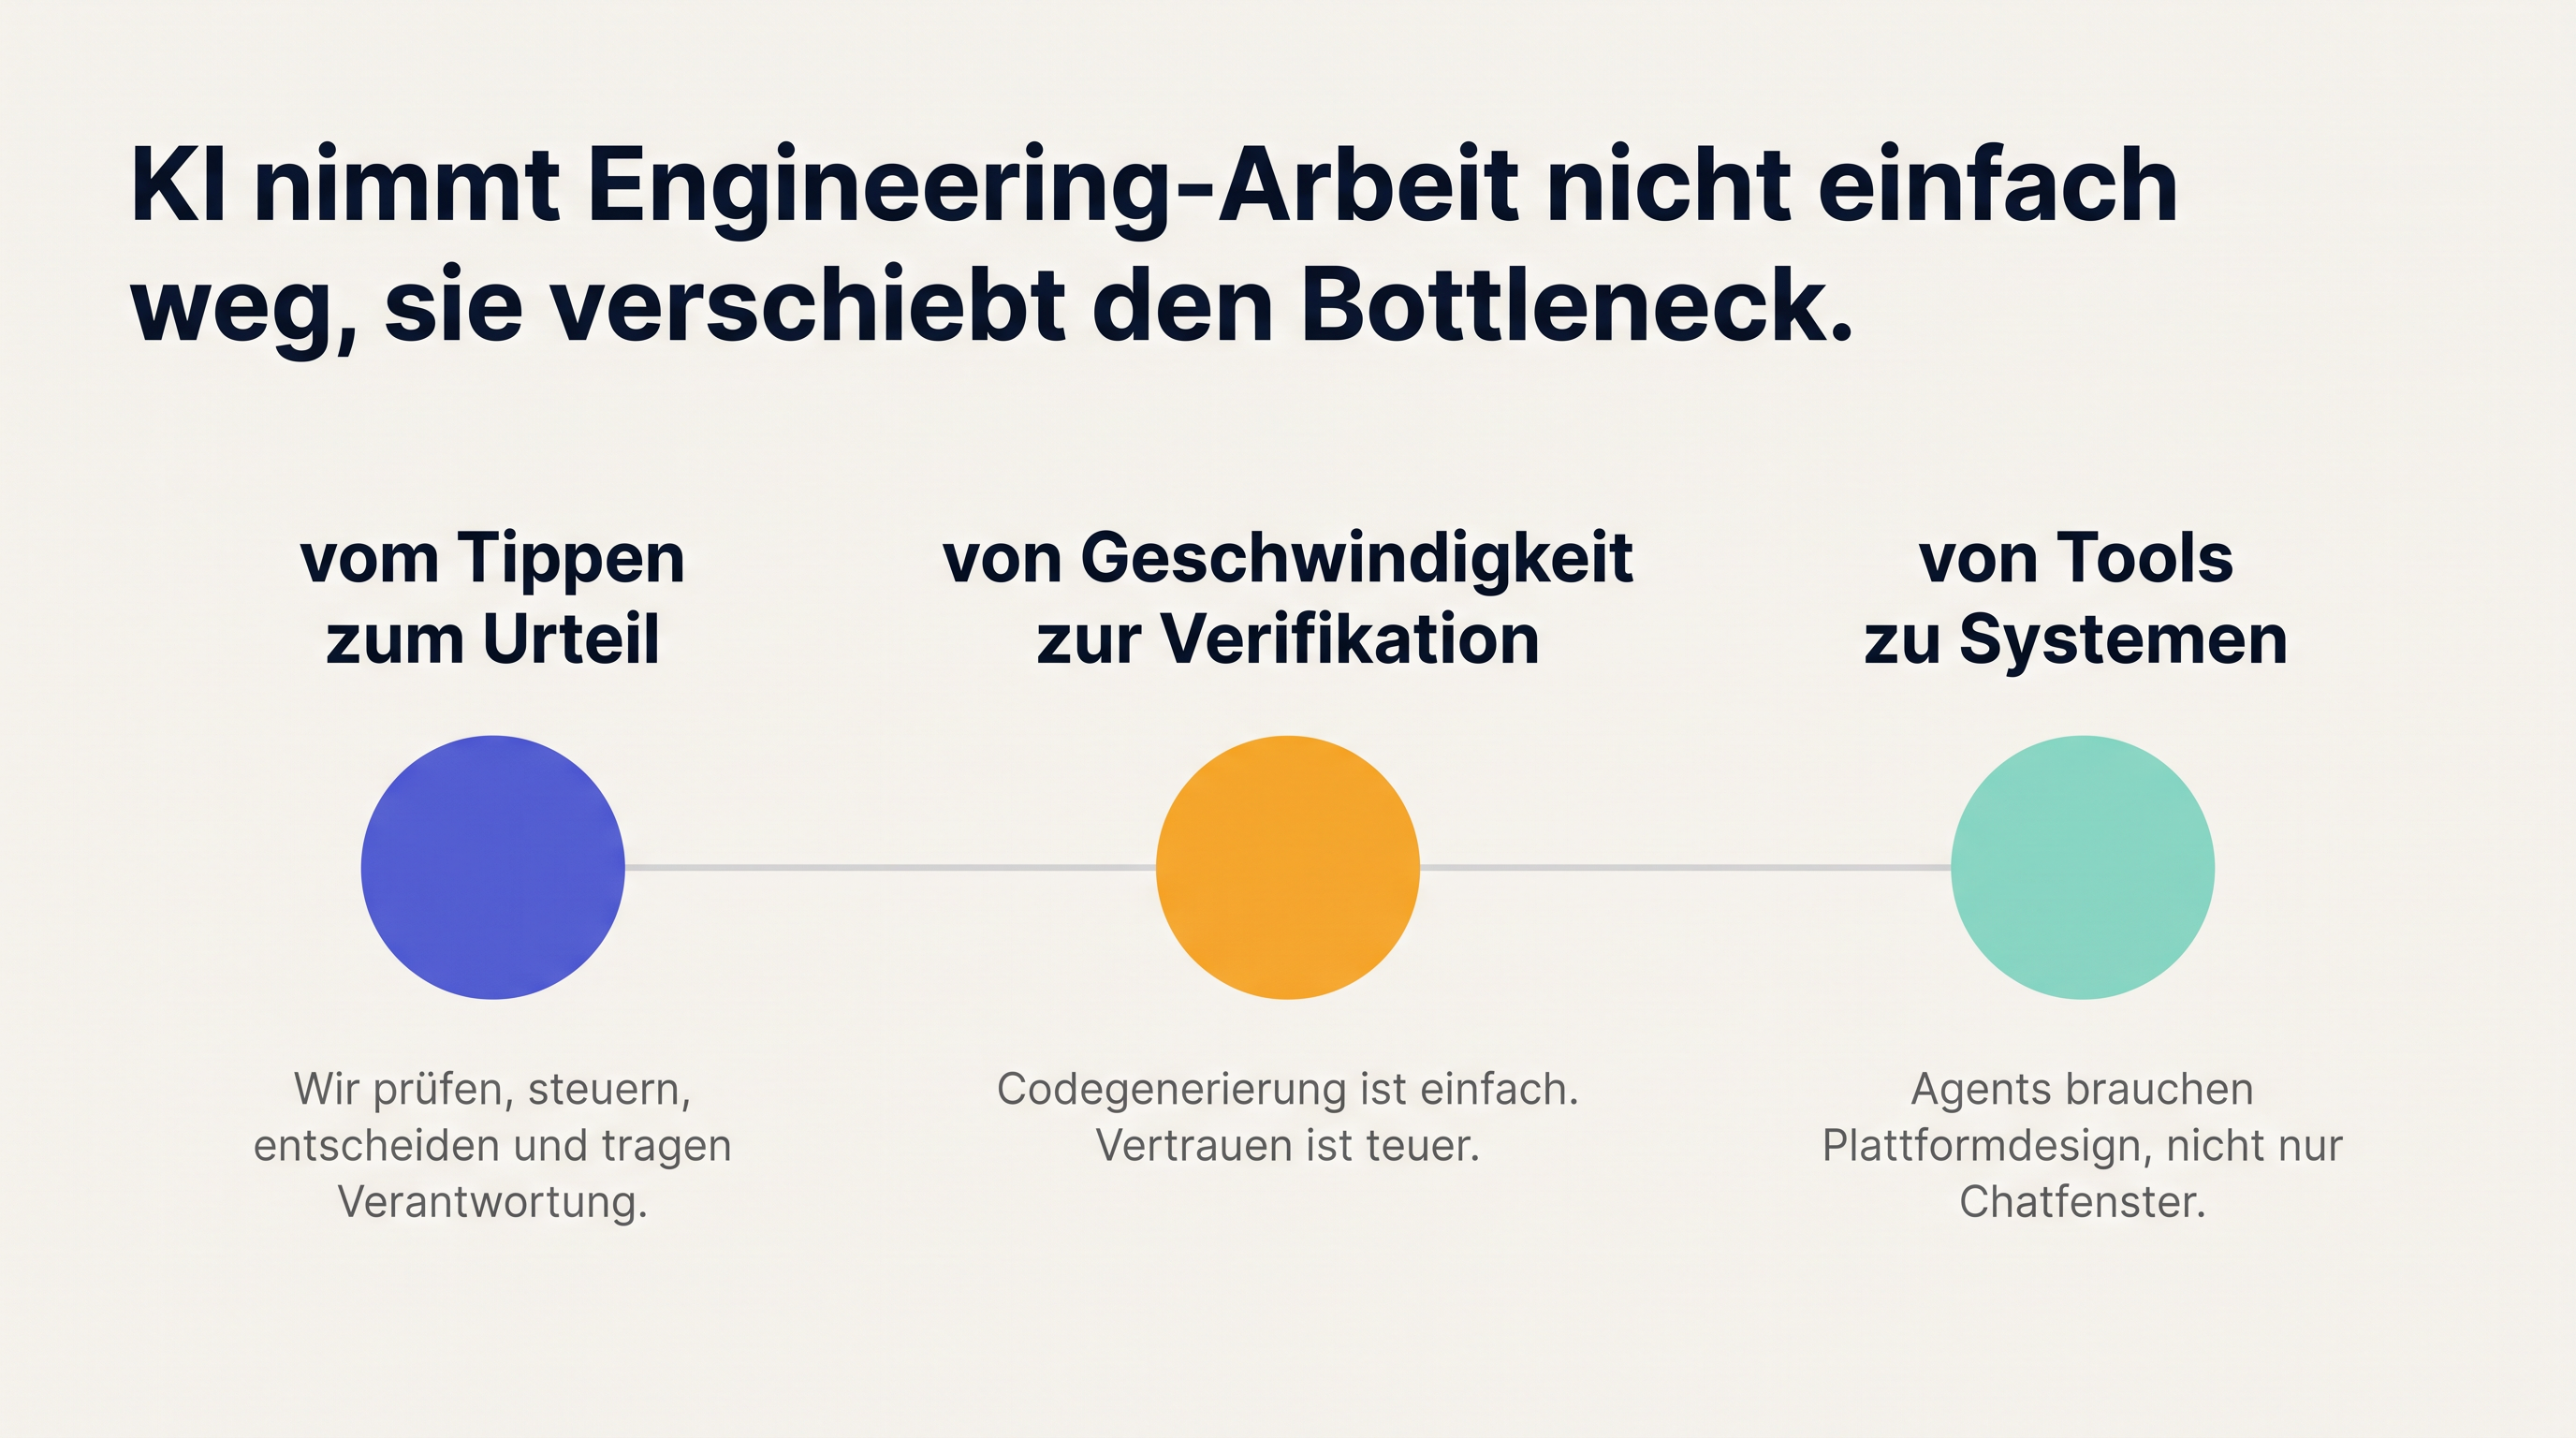
Grafik 1: Nachgebautes Schaubild auf Basis des Vortrags von Miguel Angel Mesa Cordoba beim WeAreDevelopers World Congress 2026 in Berlin.
Das ist die zentrale These, die Mesa Cordoba in seinem Vortrag entwickelt hat, und sie lässt sich in drei Verschiebungen konkretisieren, die sich in der Praxis beobachten lassen.
Die erste Verschiebung betrifft das Verhältnis von Tippen und Urteilen. Wer früher Zeit damit verbracht hat, Code zu schreiben, verbringt heute Zeit damit, KI-generierten Code zu prüfen, zu steuern und zu verantworten. Die Arbeit wirkt leichter, weil weniger getippt wird; sie kann schwerer werden, weil mehr entschieden werden muss.
Die zweite Verschiebung betrifft das Verhältnis von Geschwindigkeit und Verifikation. Codegenerierung ist einfach geworden, Vertrauen in den generierten Code ist teuer. Wer KI-Output unkritisch übernimmt, riskiert subtile Fehler, falsch-positive Tests und technische Schulden, die sich erst später zeigen, wenn der Aufwand zur Behebung deutlich höher ist als der ursprüngliche Produktivitätsgewinn.
Die dritte Verschiebung betrifft den Übergang von einzelnen Tools zu Systemen. KI-Agenten brauchen kein Chatfenster, sondern Plattformdesign. Wer KI skalieren will, braucht eine Engineering-Infrastruktur, die den zusätzlichen Output aufnehmen kann, mit klaren Guardrails, strukturierten Logs und definierten Verantwortlichkeiten.
Die drei zentralen Verschiebungen, die KI im Engineering-Alltag auslöst
|
Verschiebung |
Vorher |
Mit KI |
|
Vom Tippen zum Urteil |
Code selbst schreiben |
KI-generierten Code prüfen, steuern, verantworten |
|
Von Geschwindigkeit zur Verifikation |
Implementierungstempo als Engpass |
Vertrauen und Verifikation als Engpass |
|
Von Tools zu Systemen |
Einzelne KI-Werkzeuge im Editor |
Plattformdesign mit Guardrails, Logs, Verantwortlichkeiten |
Quelle: Vortrag von Miguel Angel Mesa Cordoba, WeAreDevelopers World Congress 2026.
Der neue Bottleneck: Urteilskraft
KI kann mehr erzeugen, als Menschen bequem bewerten können. Das ist die eigentliche Herausforderung, und sie wird in vielen Einführungsprojekten unterschätzt, weil sie sich nicht sofort in Fehlern oder Ausfällen zeigt, sondern in einer schleichenden Verschiebung der Arbeitsbelastung.
Die Anstrengung wandert. Statt Code zu schreiben, prüfen Entwickler:innen Output, korrigieren subtile Fehler, wählen zwischen plausiblen Optionen und schützen den Domain-Kontext vor Vereinfachungen, die das Modell nicht kennen kann. Das sind anspruchsvollere Tätigkeiten als Routinecoding, und sie erfordern ein tiefes Verständnis des Systems, das man entwickelt, nicht nur der Syntax, die man produziert.
Fraunhofer IESE beschreibt diesen Effekt in einer aktuellen Studie: "Die Wirkung von KI ist individuell verschieden und kontextabhängig." Erfahrene Entwickler:innen profitieren stärker, weil sie KI-Output besser einordnen können. Junior-Entwickler:innen laufen Gefahr, Fehler zu übernehmen, die sie nicht erkennen, weil ihnen das Systemverständnis fehlt, das nötig wäre, um die Plausibilität eines Vorschlags wirklich zu beurteilen.
Für IT-Leitungen bedeutet das: KI-Einführung ohne begleitende Qualitätssicherung und Review-Prozesse ist kein Produktivitätsgewinn, sondern ein verschobenes Risiko. Der Engpass verschwindet nicht, er wandert an eine Stelle, die schwerer zu messen und schwerer zu managen ist. Wie sich dieser Effekt auch bei der KI-gestützten Softwaremodernisierung zeigt, wo gut lesbarer KI-Code weniger kritisch geprüft wird als manuell geschriebener, beschreibt unser Beitrag zu Legacy-Code und KI ausführlich.
Intent wird zum neuen Input
Eine der prägnantesten Beobachtungen vom WeAreDevelopers 2026 betrifft die Art, wie sich die Kommunikation zwischen Entwickler:innen und KI-Systemen verändert. Der praktische Shift geht von "schreib diesen Code" zu "erreiche dieses Ergebnis, mit diesem Kontext, unter diesen Rahmenbedingungen." Das klingt nach einer kleinen Verschiebung in der Formulierung, ist aber in der Konsequenz eine fundamentale Veränderung dessen, was gute Engineering-Arbeit ausmacht.
Gute Prompts werden zunehmend zu kleinen Spezifikationen. Wer KI-Agenten mit Ziel, Kontext, Grenzen und Beispielen versorgt, bekommt qualitativ bessere Ergebnisse als wer einzelne Codezeilen anfordert, weil das Modell dann den Lösungsraum besser einschränken kann. Bessere Aufgabenbeschreibung plus besserer Systemkontext ergibt besseren KI-Output, das ist die einfache Formel dahinter, aber ihre Umsetzung erfordert eine Disziplin, die viele Teams erst noch entwickeln müssen.
Das hat direkte Konsequenzen für das Requirements Engineering. Anforderungen, die früher vage formuliert werden konnten, weil sich alles im Laufe der Entwicklung zusammenfügt, funktionieren mit KI-gestützten Agenten nicht mehr auf dieselbe Weise. KI braucht Präzision als Input und liefert Präzision als Output: Wer unklare Anforderungen eingibt, bekommt plausibel klingende, aber inhaltlich falsche Ergebnisse zurück, die dann aufwendig korrigiert werden müssen.
Interessant ist dabei, dass genau diese Verschiebung auch erklärt, warum klassische Low-Code- und No-Code-Plattformen ihr Versprechen nie einlösen konnten: Konfiguration erfordert dieselbe Präzision wie Prompting, nur ohne die sprachliche Zugänglichkeit, die KI-Tools heute bieten.
Altsysteme brauchen in diesem Kontext Adapter, strukturierte Logs und domain-spezifische Werkzeuge, nicht nur einen neuen KI-Assistenten, der auf unstrukturierten Daten und undokumentierten Abhängigkeiten operiert.
Grüne Tests sind nicht automatisch gute Tests
Ein Thema, das auf dem WeAreDevelopers 2026 besonders viel Aufmerksamkeit bekam, war die Frage der Testqualität im KI-Zeitalter, und die Antwort, die sich aus den Diskussionen herauskristallisierte, ist unbequem: Coverage kann gut aussehen, während das Verhalten des Systems noch nicht wirklich geschützt ist.
KI-generierte Tests neigen dazu, tautologische Assertions zu produzieren, also Tests, die technisch grün sind, aber inhaltlich nichts beweisen. Ein Test, der prüft, ob ein Ergebnis gleich sich selbst ist, testet nichts. Ein Test, der prüft, ob eine Mock-Funktion aufgerufen wurde, testet das Verhalten von Mocks, nicht das Verhalten des Systems. Und ein Test, der sich ändert, wenn die Implementierung sich ändert, aber die Anforderungen gleich bleiben, schützt genau das nicht, was er schützen sollte.
Was hilft, sind bessere Fragen an das System: Was passiert, wenn ein Eingabewert null ist, leer ist oder die erwartete Größe überschreitet? Was passiert bei einem Timeout oder bei parallelem Lauf? Kritische Pfade brauchen stärkere Mutation Scores als Hilfsfunktionen, und Assertions müssen aktiv daraufhin geprüft werden, ob sie tatsächlich etwas beweisen oder nur die Abwesenheit eines Fehlers simulieren.
Für IT-Leitungen ist das ein wichtiger Governance-Punkt: Testabdeckung als KPI ist im KI-Zeitalter nicht mehr ausreichend. Entscheidend ist, ob das Verhalten des Systems tatsächlich geschützt ist. Dieses Problem verschärft sich noch einmal, wenn KI nicht nur neuen Code schreibt, sondern auch bestehende Systeme modernisiert: Eine ausreichende Testabdeckung ist die kritischste Voraussetzung, bevor überhaupt mit KI-gestütztem Refactoring begonnen werden kann.

KI-Readiness im Engineering: Wo steht Ihr Team?
Ob Codegenerierung, Testautomatisierung oder Agentic AI: Der Einstieg gelingt leichter mit einer klaren Bestandsaufnahme der eigenen Engineering-Grundlagen. Assecor unterstützt IT-Teams bei der strukturierten Einführung von KI in bestehende Entwicklungsprozesse.
Agents brauchen Leitplanken
"Agentic" heißt nicht "grenzenlos." Das ist eine der klarsten Botschaften, die Mesa Cordoba aus Berlin mitgebracht hat, und sie ist wichtiger als sie klingt, weil die Diskussion über KI-Agenten in vielen Unternehmen noch sehr stark von Möglichkeiten geprägt ist und zu wenig von den Bedingungen, unter denen diese Möglichkeiten sicher realisiert werden können.
Das Risiko von KI-Agenten liegt nicht darin, dass sie in irgendeiner Form bösartig handeln. Sehr wohl aber besteht das Risiko, dass sie mit den falschen Rechten nützlich sind. Ein KI-Agent, der Datenbankzugriff hat, kann eine Datenbank löschen, nicht aus böser Absicht, sondern weil er die Aufgabe so interpretiert hat, wie er sie interpretiert hat, und weil niemand eine Grenze gesetzt hat, die diese Interpretation verhindert hätte. Genau das ist in einem dokumentierten Vorfall mit einem Claude-basierten Agenten passiert, der die gesamte Datenbank eines Unternehmens löschte.
Vier Prinzipien für sichere Agentic-AI-Systeme lassen sich aus den Diskussionen auf dem Kongress ableiten.
-
Das erste ist Least Privilege: Agenten bekommen eigene Identitäten und enge Tool-Rechte, also nur die Berechtigungen, die sie für die konkrete Aufgabe tatsächlich brauchen.
-
Das zweite ist ein Gateway oder Policy Decision Point zwischen Agent und Systemen, eine Kontrollschicht, die Aktionen prüft und begrenzt, bevor sie ausgeführt werden.
-
Das dritte ist der Betrieb in Sandbox-Umgebungen mit Deny-by-default-Konfiguration und vollständigem Logging, sodass jede Aktion nachvollziehbar bleibt.
-
Das vierte ist die menschliche Freigabe für riskante Aktionen: Geldtransaktionen, Datenänderungen, externe Nachrichten, all das braucht einen Human-in-the-Loop, der die Konsequenz einer Aktion bewertet, bevor sie irreversibel wird.
Wie Multi-Agenten-Systeme in diesem Kontext architektonisch aufgebaut werden und welche Anforderungen sie an die Organisation stellen, haben wir in einem eigenen Beitrag ausführlich beschrieben. Und wer verstehen möchte, wie Agenten in einem größeren Automatisierungsrahmen eingebettet werden, findet in unserem Artikel zur Hyperautomatisierung eine strategische Einordnung: Agentic AI ist dort der jüngste und zugleich anspruchsvollste Baustein eines integrierten Systems.
KI skaliert nicht auf schwachen Engineering-Grundlagen
Vor Agentic AI kommen Developer Experience und Platform Engineering. Das ist eine der wichtigsten Erkenntnisse für IT-Leitungen, weil sie eine häufige Fehleinschätzung korrigiert: Wenn die Engineering-Grundlagen fehlen, besteht ein KI-Projekt in Wahrheit oft mindestens aus zwei Projekten, nämlich das eigentliche KI-Vorhaben plus die nachgeholte Engineering- und Plattformarbeit, die vorher hätte erledigt werden sollen.
Platform Engineering liefert die Fähigkeiten, auf denen KI aufbauen kann: Plattformen, Guardrails, Automatisierung, Standards und Betriebsfähigkeit. Developer Experience zeigt, ob diese Fähigkeiten im Alltag wirklich helfen, ob also der Flow stimmt, wo Reibung entsteht, wie Feedback ankommt und wie Entscheidungswege verlaufen. Beide Dimensionen sind Voraussetzungen, keine Optionen.
Wer KI in ein Team einführt, das keine sauberen CI/CD-Pipelines, keine klaren Deployment-Standards und keine strukturierten Review-Prozesse hat, wird feststellen, dass KI das Chaos beschleunigt, nicht die Produktivität. Die Computerwoche formuliert es präzise: "Das wahre Bottleneck der Entwicklung ist nicht die Code-Erstellung selbst, sondern Validierung, Integration und ein tiefes Verständnis der zugrundeliegenden Systeme."
CI/CD neu gedacht: Vom Delivery-Tool zum Feedback-System
KI verändert auch, wie CI/CD-Pipelines gedacht werden sollten. Pipelines sind nicht mehr nur ein passiver Weg von der Entwicklung in die Produktion, sondern werden zu stärker automatisierten Feedback-Kreisläufen, die Informationen über den Zustand des Systems schneller und strukturierter zurückgeben als bisher.
Was das konkret bedeutet: Build-Logs sollten für Menschen und Agenten gleichermaßen lesbar sein, weil KI zur Fehlerdiagnose eingesetzt werden kann, aber nur dann, wenn die Logs strukturiert und maschinenlesbar aufgebaut sind. Tests, Preview-Umgebungen, Monitoring und Rollbacks bilden das Safety Net, innerhalb dessen KI bei der Diagnose helfen kann, während die Grenzen und Regeln weiterhin von Menschen definiert werden müssen. Das Ziel sind kürzere und sicherere Feedback Loops, nicht schnellere oder automatischere Merges.
Der Fokus verschiebt sich damit von der Frage, wie schneller deployt werden kann, zur Frage, wie schneller gelernt werden kann, was funktioniert und was nicht. Das ist ein anderes Optimierungsziel, und es erfordert eine andere Art, Pipelines zu bauen und zu bewerten. Wer dabei auch KI-Implementierungen erfolgreich meistern möchte, findet in unserem Leitfaden eine strukturierte Grundlage für den gesamten Einführungsprozess.
Architektur ist sozial, bevor sie technisch ist
Eine der überraschendsten Thesen vom WeAreDevelopers 2026 lautet: Ein Software-System ist auch eine Karte von Menschen, Entscheidungen, Druck und fehlenden Gesprächen. Das klingt zunächst nach einer weichen Beobachtung, hat aber harte Konsequenzen für die Art, wie Architekturrisiken identifiziert und bewertet werden.
Die Menschen, die am System arbeiten, sind die eigentlichen Expert:innen, nicht die Dashboards, die ihr Verhalten aggregieren. Metriken erklären selten, warum ein System sich so verhält, wie es sich verhält. Wissensengpässe, also Stellen, an denen nur eine Person weiß, wie ein bestimmter Teil des Systems funktioniert, und eine Fehlerkultur, die Probleme eher verbirgt als sichtbar macht, können Architekturrisiken sein, die in keinem Monitoring-Tool auftauchen. Gespräche mit Entwicklung, Betrieb und Fachseite zeigen Risiken, die Dashboards oft nicht zeigen.
Für IT-Leitungen ist das ein wichtiger Hinweis: KI-gestützte Softwareentwicklung verändert nicht nur Werkzeuge und Prozesse. Sie verändert auch, welche Gespräche geführt werden müssen und welche Entscheidungen nicht mehr implizit bleiben können, weil KI-Agenten mit implizitem Wissen nicht arbeiten können. Wie KI sicher eingesetzt werden kann, ohne dabei organisatorische Risiken zu unterschätzen, beschreibt unser Praxisleitfaden.
Tabelle: Welche Themenfelder betroffen sind
|
Themenfeld |
Was sich verschiebt |
|
Tägliche Arbeit |
Vom Tippen zum Urteil, von Geschwindigkeit zur Verifikation, von Tools zu Systemen |
|
Anforderungen |
Von vagen Tickets zu präzisen Spezifikationen als Voraussetzung für brauchbaren KI-Output |
|
Testqualität |
Von Coverage als Kennzahl zu echtem Verhaltensschutz als Ziel |
|
Agentic AI |
Von offenem Werkzeugzugriff zu Least Privilege, Sandboxing und Human-in-the-Loop |
|
Delivery-Prozess |
Von schnellerem Deployment zu kürzeren, sichereren Feedback-Loops |
Eine Zusammenfassung aller im Artikel besprochenen Verschiebungen. Quelle: Vortrag von Miguel Angel Mesa Cordoba, WeAreDevelopers World Congress 2026
Was IT-Leitungen jetzt konkret tun können
Aus den Erkenntnissen des WeAreDevelopers 2026 lassen sich fünf praxisnahe Handlungsempfehlungen ableiten, die keine abstrakten Strategiepapiere erfordern, sondern konkrete Entscheidungen im laufenden Betrieb.
-
Engineering-Grundlagen prüfen, bevor KI eingeführt wird. CI/CD-Pipelines, Review-Prozesse, Deployment-Standards und Dokumentationsqualität sind Voraussetzungen für eine erfolgreiche KI-Einführung, keine Nacharbeit, die sich parallel erledigen lässt.
-
Testqualität neu definieren. Coverage ist kein ausreichender KPI mehr. Entscheidend ist, ob das Verhalten des Systems tatsächlich geschützt ist, ob also ein Fehler im Systemverhalten zuverlässig erkannt wird, bevor er in Produktion geht.
-
Klare Grenzen für KI-Agenten setzen. Least Privilege, Sandboxing und Human-in-the-Loop für riskante Aktionen sind keine optionalen Sicherheitsmaßnahmen, sondern Grundvoraussetzungen für den produktiven Einsatz von Agentic AI.
-
Requirements-Qualität erhöhen. KI braucht präzise Anforderungen als Input. Vage Tickets, die in der klassischen Entwicklung noch tolerierbar waren, produzieren mit KI-Agenten plausibel klingende, aber inhaltlich falsche Ergebnisse.
-
Urteilskraft als Ressource einplanen. KI erzeugt mehr Output, als Teams bequem bewerten können. Wer das nicht in der Kapazitätsplanung berücksichtigt, schafft keinen Produktivitätsgewinn, sondern einen neuen Engpass an einer Stelle, die schwerer zu messen ist als die alte.

Vom Vortrag zur Umsetzung: Wie führen Sie KI strukturiert in Ihrem Unternehmen ein?
Die Erkenntnisse aus diesem Artikel zeigen, wie viel an Vorbereitung eine erfolgreiche KI-Einführung im Engineering braucht, von sauberen Prozessen bis zu klaren Verantwortlichkeiten. Unser Whitepaper führt diesen Gedanken weiter und zeigt Schritt für Schritt, wie Unternehmen KI strategisch einführen, organisatorisch verankern und nachhaltig skalieren.
Fazit: Besseres Engineering mit KI
KI macht Softwareentwicklung produktiver, aber nur dann, wenn die Engineering-Grundlagen stimmen, die Prozesse mitwachsen und die Urteilskraft der Menschen im Mittelpunkt bleibt. Das ist die Kernbotschaft, die mein Kollege Miguel Angel Mesa Cordoba vom WeAreDevelopers World Congress 2026 mitgebracht hat, und die ich in diesem Artikel für unsere Kund:innen und Partner:innen eingeordnet habe. Sie ist weniger eine Warnung vor KI als eine Einladung, Engineering ernsthafter zu nehmen als bisher.
Für Entwickler:innen bedeutet das: Die wichtigsten Skills sind zunehmend Systemverständnis, kritisches Denken und die Fähigkeit, KI-Output präzise zu bewerten, also genau die Fähigkeiten, die sich nicht durch ein Tool ersetzen lassen.
Für IT-Leitungen bedeutet das: KI-Einführung ist kein Tool-Rollout. Sie ist eine Engineering-Transformation, die Investitionen in Plattformen, Prozesse, Qualitätssicherung und Teamkompetenz erfordert, und die genau dann scheitert, wenn diese Investitionen als optional behandelt werden. Wer die Vorteile von KI langfristig realisieren möchte, kommt an dieser Grundlagenarbeit nicht vorbei.
FAQ
Was ist KI-gestützte Softwareentwicklung?
KI-gestützte Softwareentwicklung bezeichnet den systematischen Einsatz von KI-Modellen und Werkzeugen entlang des gesamten Software Development Lifecycle, von Anforderungserfassung und Codegenerierung über Testing und Code-Review bis zu Deployment und Wartung. Ziel ist es, Entwicklerteams schneller, fehlerfreier und skalierbarer arbeiten zu lassen.
Wie verändert KI die Rolle von Entwickler:innen?
KI verschiebt den Fokus vom reinen Codeschreiben hin zu Systemverständnis, Architekturentscheidungen, Code-Review und der Steuerung von KI-Agenten. Entwickler:innen geben zunehmend die Richtung vor, bewerten KI-Vorschläge kritisch und tragen Verantwortung für das Gesamtsystem, also für Entscheidungen, die früher implizit im Schreibprozess getroffen wurden.
Welche Risiken hat KI-generierter Code?
KI-generierter Code kann subtile Fehler, tautologische Tests, Sicherheitslücken und technische Schulden enthalten, die Standard-Scans übersehen. Erfahrene Reviews, semantische Analysen und ein tiefes Systemverständnis der Entwickler:innen bleiben deshalb unverzichtbar, auch wenn der Code auf den ersten Blick korrekt aussieht.
Was ist der neue Bottleneck, wenn KI das Coding beschleunigt?
Wenn KI die Codegenerierung beschleunigt, verlagert sich der Engpass auf Verifikation, Urteilskraft und Systemverständnis. KI kann mehr erzeugen, als Menschen bequem bewerten können, und die Anstrengung wandert von der Implementierung zur Prüfung, Entscheidung und Verantwortung.
Kann KI Entwickler:innen ersetzen?
KI verändert die Rolle von Entwickler:innen grundlegend, ersetzt sie aber nicht. Systemverständnis, kritisches Denken, Architekturentscheidungen und die Verantwortung für das Gesamtsystem bleiben menschliche Aufgaben. Laut Fraunhofer IESE bleibt der Mensch auch im KI-gestützten Entwicklungsprozess zentral, weil KI-Output ohne menschliche Urteilskraft nicht zuverlässig bewertet werden kann.

Teilen


